
Gli algoritmi di clustering servono a individuare gruppi all’interno di un insieme di dati. Possono essere usati, per esempio, quando si vogliono riconoscere insiemi di elementi simili senza avere già categorie definite in partenza. L’idea di base è semplice: dati che si assomigliano vengono raccolti nello stesso gruppo, mentre dati diversi vengono separati.
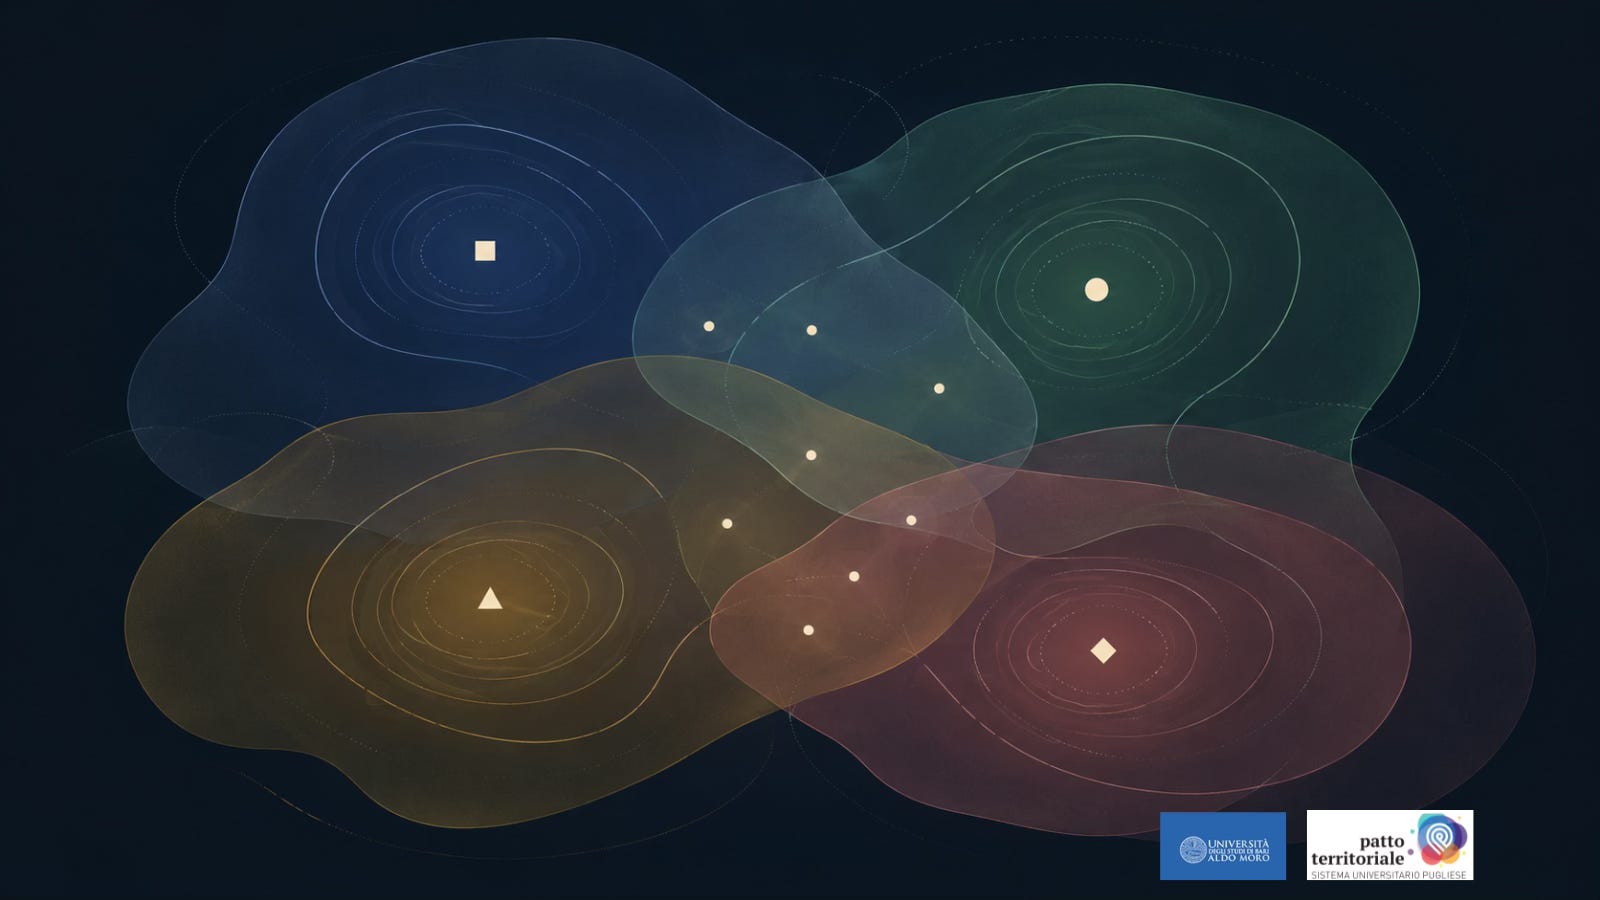
In molti metodi di clustering, ogni dato viene collocato in un solo gruppo. È una scelta chiara, ma non sempre adatta a descrivere tutte le possibili situazioni dei diversi contesti reali. Un elemento può avere caratteristiche che lo avvicinano a più gruppi, senza appartenere completamente a uno solo. Il Fuzzy C-Means è un algoritmo di clustering ampiamente utilizzato che presenta una particolarità: esso non assegna ogni dato a un solo gruppo in modo rigido, ma calcola quanto quel dato sia vicino, o comunque riconducibile, a ciascuno dei gruppi individuati. In questo modo un elemento può risultare associato in parte a un gruppo e in parte a un altro. È una soluzione utile quando i confini tra gruppi non sono netti: il Fuzzy C-Means produce per ogni dato una serie di valori, uno per ciascun cluster, e la somma di questi valori deve risultare sempre pari a uno. Nonostante tutto ciò avvenga mediante un meccanismo di funzionamento noto e ben studiato, resta aperta una domanda importante: che cosa significano davvero i valori ottenuti?
A prima vista, si potrebbe pensare che i risultati del Fuzzy C-Means non siano altro che gradi di appartenenza, utili per misurare semplicemente la somiglianza tra un dato e il prototipo del cluster, cioè il punto che rappresenta in modo sintetico quel gruppo. In questa lettura, più un dato è vicino al prototipo, più dovrebbe appartenere a quel cluster; più è lontano, meno dovrebbe appartenervi. Lo studio mostra però che questa spiegazione non è sufficiente. Nel Fuzzy C-Means i valori prodotti dall’algoritmo possono avere un andamento non riconducibile alla sola vicinanza geometrica. In alcune configurazioni, un punto più lontano dal prototipo può ricevere un grado di appartenenza maggiore rispetto a un punto più vicino. Il numero prodotto dall’algoritmo, quindi, funziona nel calcolo, ma non può essere spiegato solo come misura diretta di somiglianza.
Per descrivere questa situazione, i gradi di appartenenza del Fuzzy C-Means sono stati spesso interpretati come “gradi di condivisione”. L’espressione suggerisce che un dato non venga attribuito in modo esclusivo a un cluster, ma sia in qualche modo distribuito tra più gruppi. Tuttavia, se resta affidata alla sola intuizione, questa formula non basta. Dire che un dato “condivide” più cluster può essere comprensibile in senso generale, ma non chiarisce fino in fondo che cosa rappresenti il valore assegnato dall’algoritmo. Il problema diventa particolarmente rilevante quando questi risultati devono essere spiegati: non è sufficiente sapere che un dato ha un certo grado di appartenenza a un cluster, occorre anche capire se quel valore indichi somiglianza, probabilità, incertezza o qualcos’altro. È qui che il tema entra nel campo dell’intelligenza artificiale spiegabile.
Il punto centrale dello studio è dare a quei valori un significato più chiaro. Invece di considerarli soltanto come gradi di appartenenza “difficili da interpretare”, la ricerca mostra che possono essere letti in termini probabilistici. In altre parole, se l’algoritmo assegna a un dato un certo valore rispetto a un cluster, quel valore può essere interpretato come la probabilità che quel dato appartenga proprio a quel cluster. Questa lettura vale solo dentro un modello preciso, costruito su alcune ipotesi dichiarate: per esempio, che all’inizio i cluster abbiano lo stesso peso e che la probabilità di osservare un dato dipenda anche dalla sua distanza dal prototipo del cluster. In questo quadro, il grado di appartenenza diventa una probabilità a posteriori, cioè una probabilità valutata dopo aver osservato il dato.
Lo studio ha il merito di dimostrare formalmente questo risultato, producendo così alcuni risultati tangibili nel campo della ricerca sugli algoritmi di clustering. In primo luogo, è possibile sotto certe assunzioni interpretare meglio i risultati di un algoritmo noto in letteratura riconducendo i suoi risultati a un significato più preciso. Inoltre, pur senza modificare il funzionamento dell’algoritmo, né nascondendone la sua complessità, si propone un punto di vista alternativo che consente di collegare i valori ottenuti a un quadro teorico esplicito, che è quello probabilistico. Su queste basi, è possibile applicare al Fuzzy C-Means gli approcci metodologici tipici dell’analisi probabilistica al fine di ricavare miglioramenti, estensioni e nuove intuizioni teoriche riguardo al meccanismo di clustering messo in atto.
A tale proposito, lo studio ha una conseguenza pratica anche sulle implicazioni legate all’impostazione di uno dei parametri del Fuzzy C-Means, il cosiddetto parametro di fuzzificazione. Esso viene solitamente fissato dall’utente, prima di applicare l’algoritmo. Invece, il punto affrontato dallo studio è che questo parametro introduce un’ipotesi sul modo in cui i dati sono disposti nello spazio poiché contribuisce a descrivere la probabilità di maggiore o minore concentrazione dei dati intorno ai prototipi. Per questo, se il parametro viene scelto a priori, senza osservare la distribuzione effettiva dei dati, il modello incorpora un’ipotesi che resta in parte non verificata: lo studio suggerisce invece che potrebbe essere utile derivare il parametro dall’analisi dei dati stessi, invece di trattarlo come una semplice “manopola tecnica”. Ancora una volta, il contributo consiste nel rendere più leggibile il funzionamento dell’algoritmo, mirando non solo alla precisione dei risultati ma anche alla comprensione del loro significato.
Questo articolo nasce nell’ambito delle attività di Terza Missione promosse da Stroncature in collaborazione con l’Università degli Studi di Bari Aldo Moro, nel quadro delle iniziative di Public Engagement finanziate dal “Bando per Finanziamento di Iniziative di Public Engagement” a valere sul Progetto “Sistema Universitario Pugliese”, finanziato nell’ambito della misura “Patti Territoriali dell’Alta Formazione per le Imprese” (CUP F61B23000370006). Il testo rielabora in forma divulgativa il contributo scientifico “A Bayesian Interpretation of Fuzzy C-Means” di Corrado Mencar e Ciro Castiello, del Dipartimento di Informatica dell’Università degli Studi di Bari Aldo Moro, per renderne i contenuti più fruibili a un pubblico non specialista.
